OpenAI, Google y Microsoft preparan una regla común para evitar que la IA entrene con contenidos de sitios web
OpenAI, Google, Microsoft y Anthropic respaldan una señal común en robots.txt para que los medios puedan rechazar el uso de sus contenidos en el entrenamiento de IA. Su aplicación comenzará de forma gradual y no bloqueará automáticamente el rastreo.
Por Redacción Notiva · · Actualizado
OpenAI, Google, Microsoft y Anthropic respaldan una propuesta que permitirá a los editores expresar desde un solo archivo su preferencia para que sus artículos no sean utilizados en el entrenamiento de modelos de inteligencia artificial. El mecanismo aún no está plenamente operativo y no impide por sí mismo que los bots accedan a las páginas.
Los medios de comunicación podrían contar con una manera más sencilla de comunicar a varias empresas tecnológicas que no desean que sus noticias se utilicen para entrenar sistemas de inteligencia artificial (IA). El 30 de octubre de 2026, OpenAI, Google y Microsoft anunciaron su intención de respetar una señal compartida en el archivo robots.txt, mientras Anthropic informó que ya trabaja en su implementación.
La iniciativa busca reducir la necesidad de mantener instrucciones distintas para cada proveedor de IA. Sin embargo, se trata de una propuesta técnica en desarrollo, no de una prohibición universal ni de un bloqueo automático de rastreadores.
¿Qué acordaron OpenAI, Google, Microsoft y Anthropic?
Las compañías apoyan el uso de una preferencia común que identifica si el contenido de determinadas rutas de un sitio puede utilizarse para entrenar modelos generativos. El planteamiento forma parte de un borrador presentado ante el grupo de trabajo AI Preferences de la Internet Engineering Task Force (IETF), por Kevin Kelley, de Anthropic.
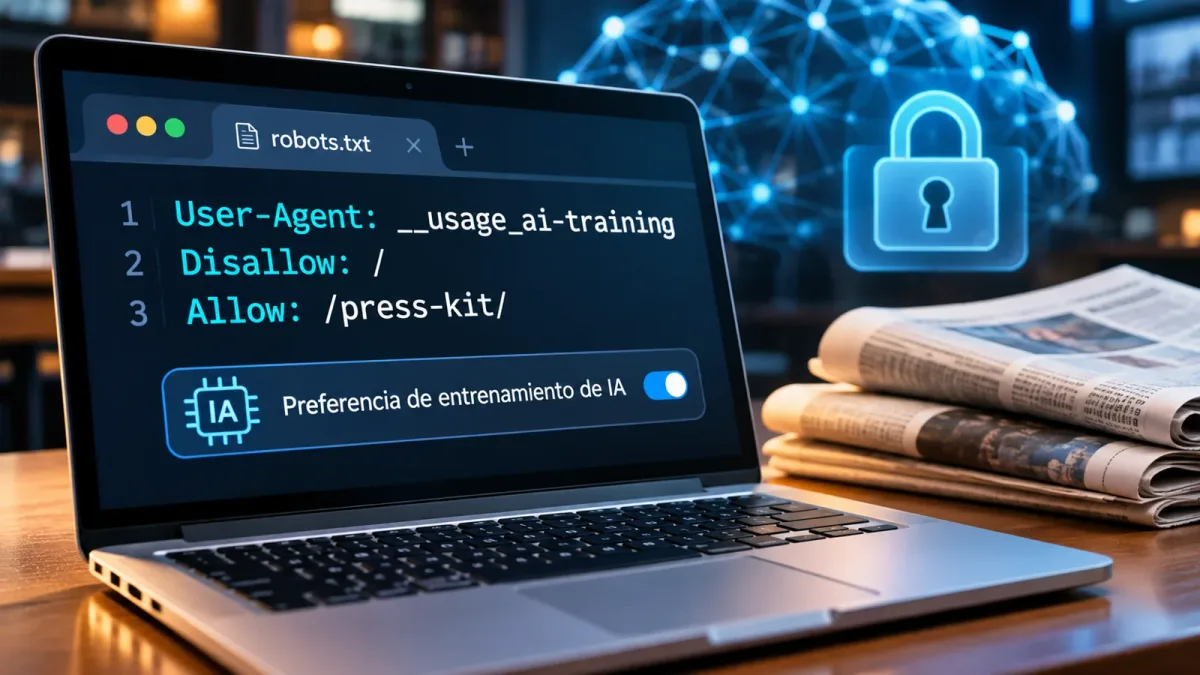
El borrador propone incorporar el identificador __usage_ai-training en un grupo convencional de robots.txt. Así, los sitios podrán manifestar su preferencia sin redactar una exclusión diferente para cada empresa participante.
El cambio solo será respetado por los proveedores que lo implementen y no supone que todos los servicios de IA hayan aceptado el mismo mecanismo.
¿Cómo funcionará la nueva instrucción de robots.txt?
Un editor podrá publicar, por ejemplo, estas líneas en el archivo robots.txt de su dominio:
User-Agent: __usage_ai-training
Disallow: /
La primera línea identifica la preferencia relacionada con el entrenamiento de IA; la segunda expresa que no se desea que el contenido del sitio se utilice para ese fin. El borrador también permite establecer excepciones para rutas concretas mediante Allow.
A diferencia de una instrucción que bloquea a un rastreador específico, esta señal indica una preferencia sobre el uso posterior del contenido. No evita por sí misma las visitas automatizadas, no elimina materiales ya utilizados para entrenar modelos y no reemplaza los acuerdos de licencia existentes.
¿Cuándo comenzará a funcionar?
La adopción no ocurrirá al mismo tiempo en todas las plataformas:
- Microsoft: prevé respetar la señal a partir del 1 de febrero de 2027, conforme vuelva a rastrear las páginas.
- Google: planea incorporarla durante 2027; ha indicado que la interpretará de forma relacionada con su control Google-Extended cuando este último no esté definido expresamente.
- OpenAI: anunció que pretende implementarla en los próximos meses, sin comunicar una fecha exacta.
- Anthropic: señaló que ya inició los trabajos de implementación, aunque el despliegue completo aún no tiene una fecha confirmada.
Por ahora, los administradores de sitios deben revisar los controles específicos que ofrecen los proveedores que les interesa limitar.
¿La medida impedirá que ChatGPT, Gemini o Copilot muestren noticias?
No necesariamente. Existe una diferencia entre entrenar un modelo con contenido y consultar información actual para generar una respuesta.
La propuesta compartida se refiere al entrenamiento de modelos de IA generativa. No establece un control universal que impida que una herramienta consulte una página o utilice su información como contexto para contestar a un usuario.
Microsoft ha anunciado controles adicionales para distinguir entre entrenamiento (AI Training) y uso de contenidos para fundamentar respuestas (AI Grounding). Estos ajustes serán independientes de la señal compartida y podrán configurarse a nivel de página en sus servicios.
Google, por su parte, mantiene reglas propias, como Google-Extended, cuyo alcance no es idéntico al de los controles de otros proveedores.
¿Puede afectar el posicionamiento de un medio en Google o Bing?
Las empresas aseguran que el nuevo mecanismo permite expresar preferencias sobre el entrenamiento sin bloquear necesariamente la aparición del sitio en los resultados de búsqueda convencionales.
Esto es relevante para los medios digitales que buscan proteger sus publicaciones sin perder visibilidad en los buscadores, una fuente importante de lectores y tráfico publicitario.
No obstante, las diferencias entre rastreo, indexación, entrenamiento y respuestas generadas con IA obligan a revisar con atención la configuración de cada plataforma. Bloquear por error a un bot de búsqueda sí puede tener efectos distintos a expresar una preferencia sobre el entrenamiento.
¿Por qué los medios buscan limitar el uso de sus artículos por la IA?
El crecimiento de los asistentes generativos ha intensificado las discusiones sobre el uso de contenido periodístico sin autorización y sobre la posibilidad de que algunas respuestas de IA reduzcan las visitas a los sitios de origen.
Entre los casos más conocidos se encuentra la demanda presentada por The New York Times contra OpenAI y Microsoft en diciembre de 2023, relacionada con el presunto uso no autorizado de sus publicaciones para entrenar modelos. La existencia del litigio no constituye, por sí misma, una resolución sobre responsabilidad.
El nuevo mecanismo no resuelve las disputas por derechos de autor ni establece pagos a los editores. Su propósito es ofrecer una forma técnica más uniforme para expresar preferencias de uso.
¿Qué sigue para los administradores de sitios web?
El documento publicado ante la IETF todavía es un borrador y puede sufrir modificaciones. Su adopción dependerá de cada compañía y de los resultados del proceso de estandarización.
Para medios y portales informativos, el primer paso es distinguir qué desean limitar: el entrenamiento de modelos, el rastreo de bots o la utilización de artículos en respuestas generadas por IA. Cada objetivo puede requerir herramientas diferentes.
La principal novedad es que varios proveedores importantes respaldan una señal común para el entrenamiento de IA; su eficacia práctica dependerá de que se implemente y respete en cada servicio.
Fuentes
- OpenAI
- Microsoft
- Anthropic
- inteligencia artificial
- robots.txt
- Derechos de autor
- Medios digitales
- IETF
- ChatGPT
- Gemini
- Copilot
- bloquear entrenamiento de IA con noticias
- OpenAI Google Microsoft robots.txt
- control entrenamiento inteligencia artificial
- __usage_ai-training
- proteger noticias de la IA
- bloquear bots IA
- AIPREF IETF
- derechos de autor medios IA
- Kevin Kelley
- AIPREF